
📌 Executive Summary & Key Insights
"최신 LLM(대형 언어 모델)이 금융 뉴스와 공시를 인간보다 빠르게 이해한다면, 주식 시장에서 초과 수익(Alpha)을 거둘 수 있을까?"
많은 트레이더와 개발자가 LLM 기반의 뉴스 감성 분석 및 자동화 투자를 시도하지만, 실전 매매에서는 기대만큼의 수익이 나지 않거나 오히려 손실을 기록하곤 합니다. 본 포스팅에서는 AI가 뉴스를 완벽히 이해해도 주식 수익으로 이어지지 않는 구조적 이유와 실전 퀀트 투자에서 LLM을 올바르게 활용하는 레이어별 접근법을 다룹니다.
💡 핵심 인사이트 (Key Takeaways)
- 정보 해석과 시점의 불일치 (Latency & Market Efficiency)
- 공개된 뉴스는 이미 시장 가격에 반영(Priced-in)된 후일 가능성이 높습니다. LLM이 아무리 호재/악재를 정확히 판별해도, 진입 시점이 늦으면 휩소(Whipsaw)나 상투를 잡는 결과로 이어집니다.
- 단순 감성 분석(Sentiment Analysis)의 한계
- "실적 발표 후 주가 상승"과 같은 직관적 연결은 금융 시장의 복잡계(Complex System)에서 작동하지 않습니다. 동일한 호재도 선반영 여부, 마켓 레짐(Market Regime), 수급 상황에 따라 하락 재료로 작용할 수 있습니다.
- 환각(Hallucination)과 맥락 왜곡 리스크
- 금융 데이터 특유의 수치적 엄밀함과 문맥적 행간을 LLM이 자의적으로 해석할 경우, 치명적인 오판 시그널을 생성할 위험이 존재합니다.
- 실전 퀀트에서의 올바른 LLM 역할: '독립 시그널'이 아닌 '보조 필터'






AI가 뉴스를 완벽히 읽으면 주식 시장을 이길 수 있을까? (언어 지능과 알파의 디커플링)
AI 모델이 뉴스에서 호재와 악재를 귀신같이 구분해 낸다면, 과연 주식 시장에서 지속적인 초과 수익(Alpha)을 거둘 수 있을까요? 최근 존스 홉킨스 대학교 연구진이 발표한 연구 논문("From Financial Sentiment Classification to Return Predictability")은 퀀트 투자자와 AI 트레이더들에게 대단히 중요한 충격을 줍니다.
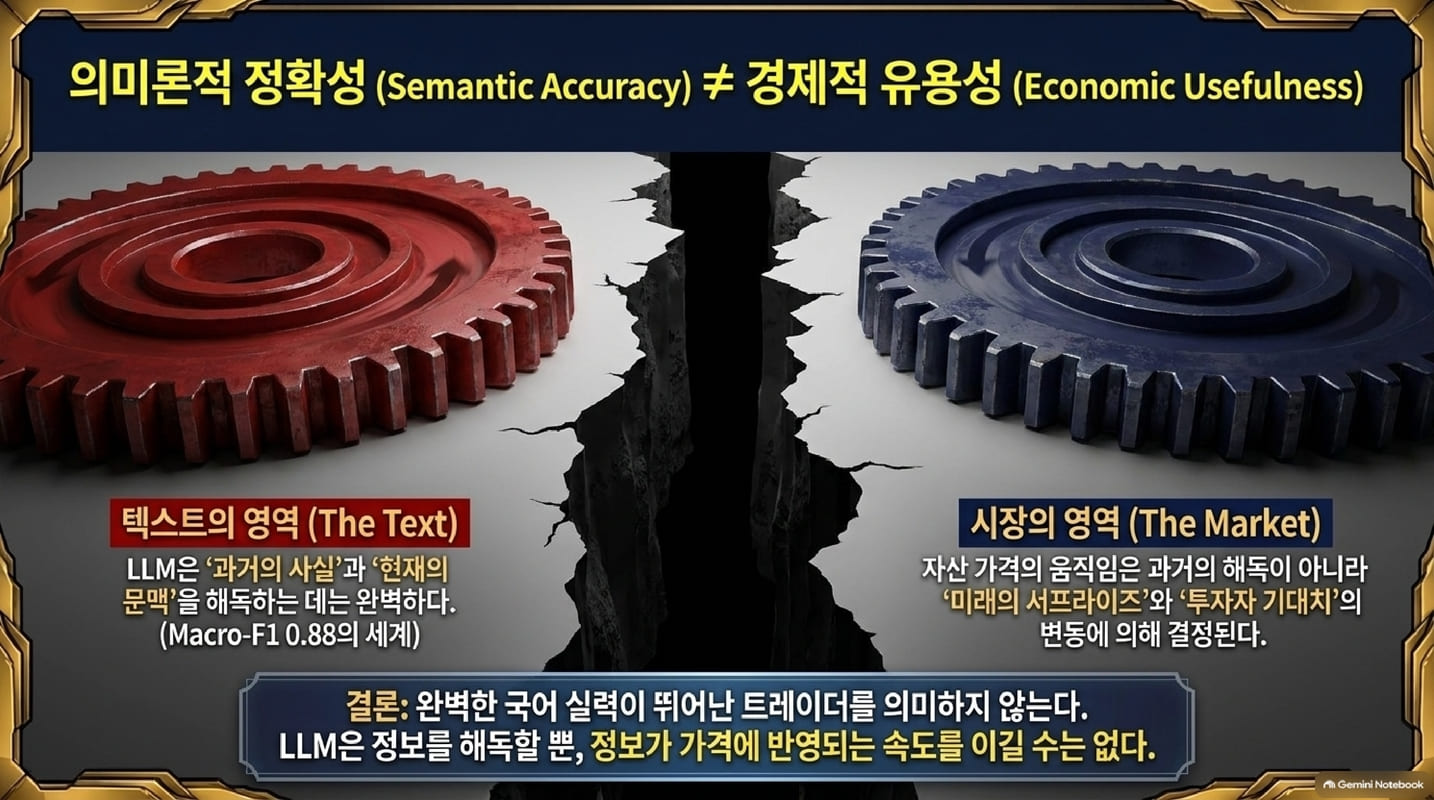
결론부터 말하자면 "AI의 정교한 언어 지능(NLP 성능)과 실제 주가 초과 수익률(알파)은 전혀 비례하지 않는다"는 점입니다. 최신 거대 언어 모델(LLM)과 금융 감성 분석 모델의 최신 벤치마크 데이터를 통해 언어적 해상도와 실전 투자 수익 간의 구조적 괴리를 분석해 봅니다.
QLoRA의 마법: 7B~8B LLM을 금융 전문가로 만드는 방법
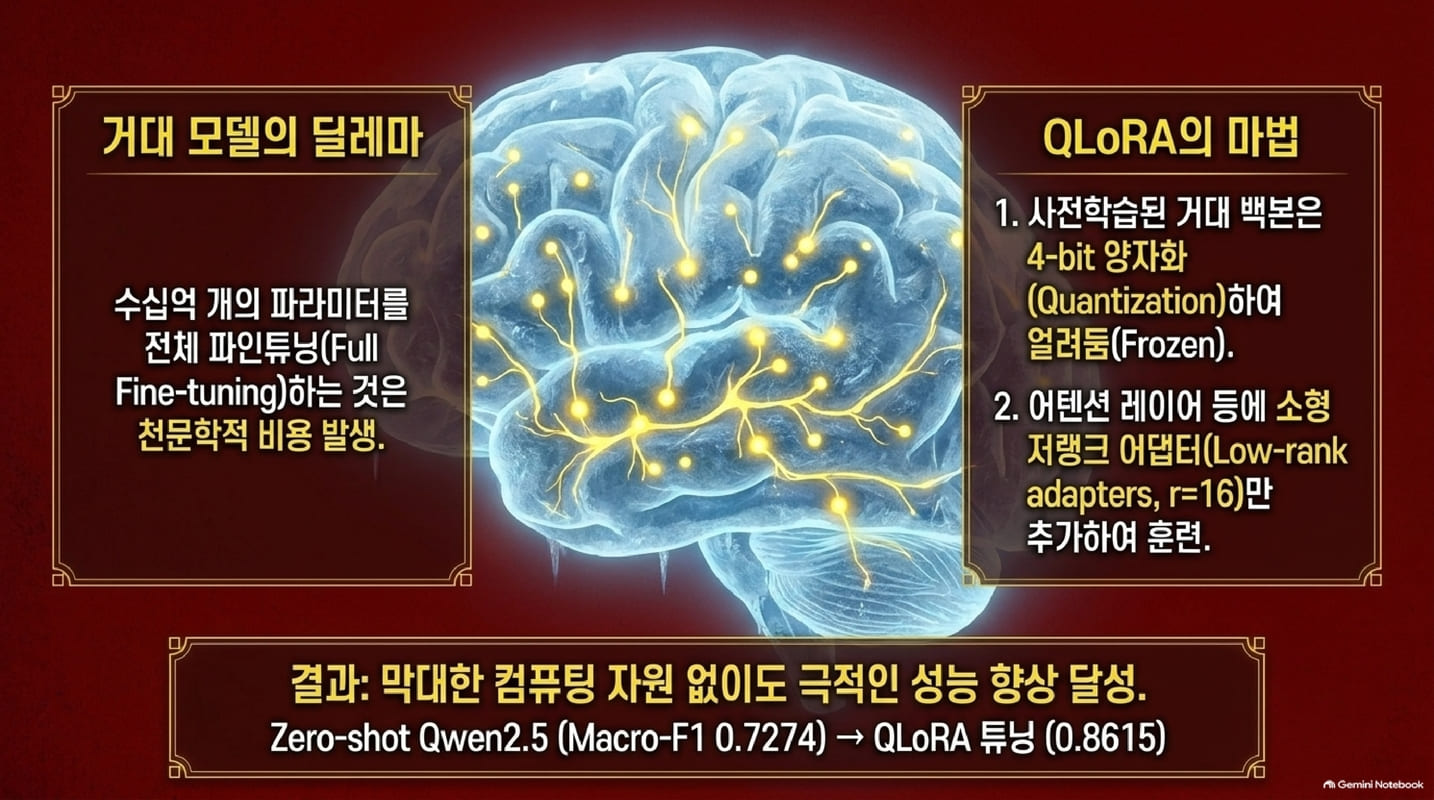
거대한 언어 모델을 금융 데이터에 맞게 조정하는 데 있어 QLoRA(Quantized Low-Rank Adaptation) 기술은 압도적인 효율성을 입증했습니다. 4비트 양자화 기술을 결합해 모델 가중치를 동결하고 소량의 어댑터만 학습시키는 이 방식은 적은 컴퓨팅 자원으로도 LLM의 금융 도메인 이해도를 비약적으로 상승시켰습니다.
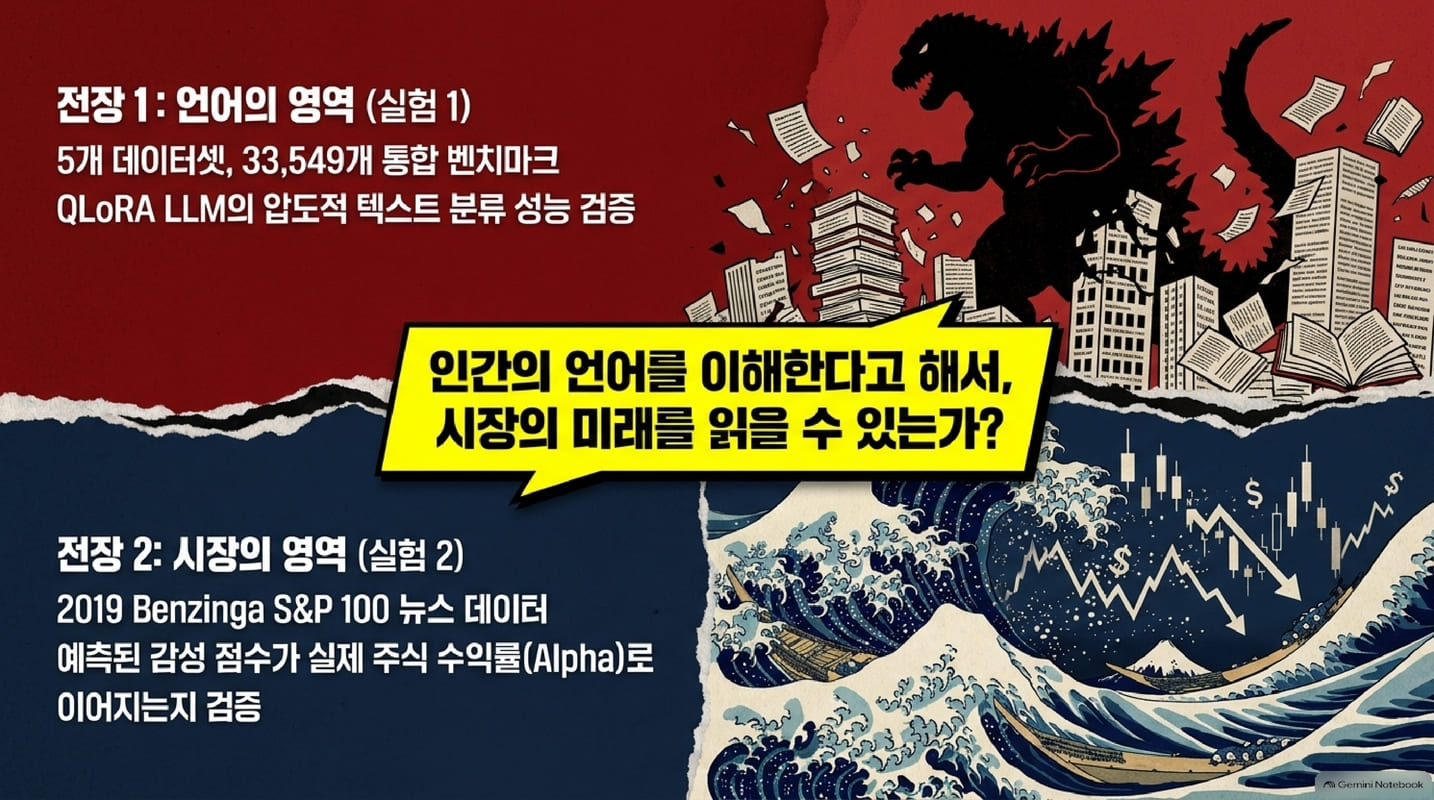
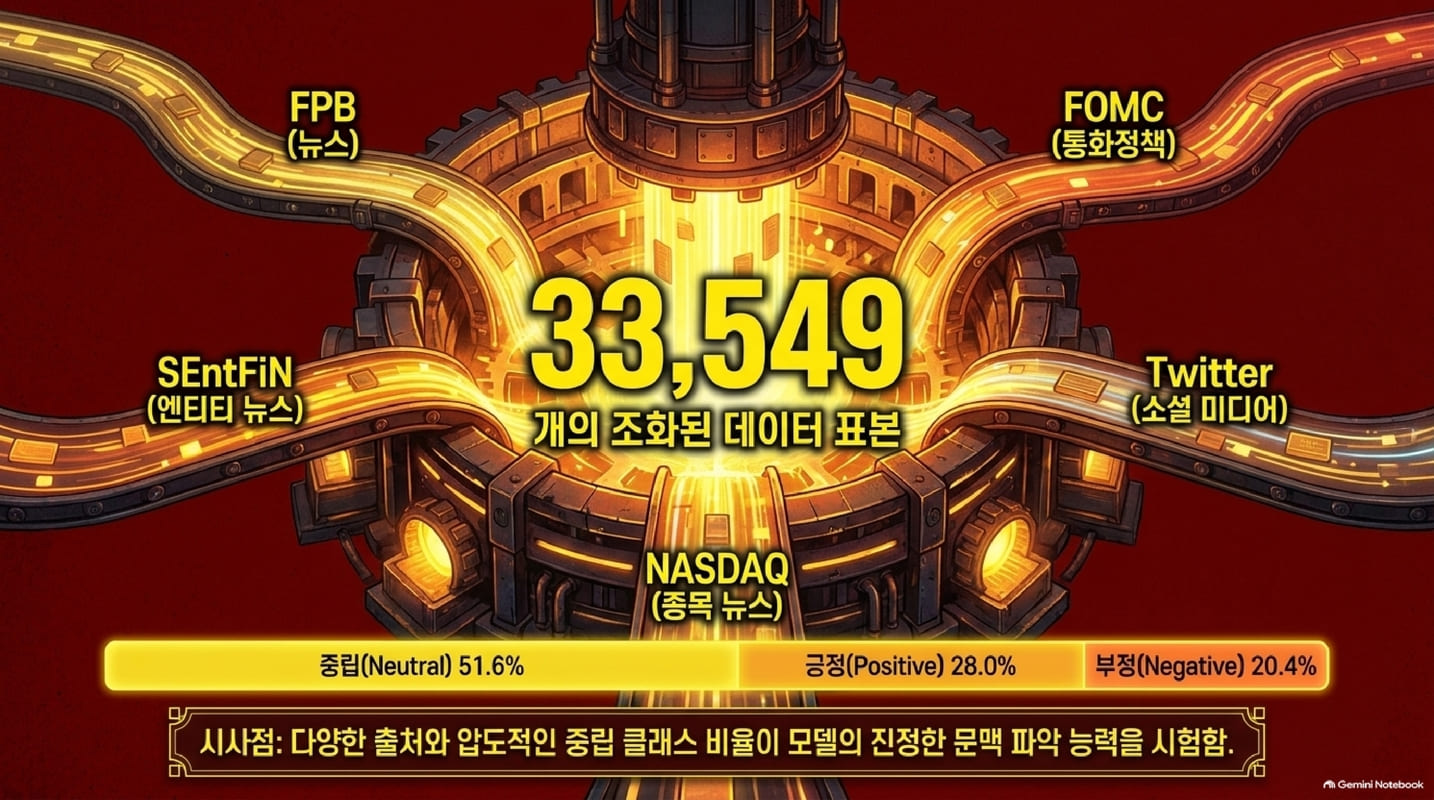
FPB, FOMC, SEntFiN 등 5개 금융 텍스트 데이터셋을 통합한 벤치마크(Experiment 1)의 테스트 결과는 다음과 같습니다.
| 모델 (Model) | 학습/적용 방식 | Accuracy | Macro-F1 | 비고 |
| Mistral-7B | QLoRA | 0.8840 |
0.8771 |
분류 성능 전체 1위 |
| LLaMA3-8B | QLoRA | 0.8814 | 0.8753 | 근소한 차이의 2위 |
| Qwen2.5-7B | QLoRA | 0.8683 | 0.8615 | Zero-shot(0.7274) 대비 급상승 |
| FinBERT | Pretrained Off-the-shelf | 0.6930 | 0.6753 | 파인튜닝 없는 도메인 인코더 |
| Financial-RoBERTa | Pretrained Off-the-shelf | 0.6622 | 0.6679 | 파인튜닝 없는 도메인 인코더 |
| TF-IDF + Naive Bayes | Supervised Fit | 0.6976 | 0.6334 | Traditional ML Baseline |
- QLoRA의 비약적 성과: Qwen2.5-7B는 학습이 없는 제로샷(Zero-shot) 상태에서 Macro-F1 점수가 0.7274에 불과했으나, QLoRA 파인튜닝 후 0.8615로 급등했습니다.
- 손실 함수 보정의 한계: 금융 데이터의 클래스 불균형을 완화하기 위해 적용한 역빈도 가중 손실(Inverse-frequency Class-weighted Loss)은 오히려 Qwen2.5의 Macro-F1을 0.8595로 소폭 감소시켰습니다. 단순한 통계적 가중치보다는 모델 자체의 도메인 적응력이 더 중요함을 뜻합니다.
- 오류의 성격: LLM 오분류의 대부분은 긍정과 부정의 완전한 극성 반전(Reversal)이 아니라, '방향성(긍정/부정)과 중립' 사이의 모호함에서 발생했습니다 (LLaMA3 및 Mistral의 극성 반전 비율은 1.3% 수준).
반전의 퀀트 실전: FinBERT의 활약과 '0'으로 수렴한 통계적 유의성
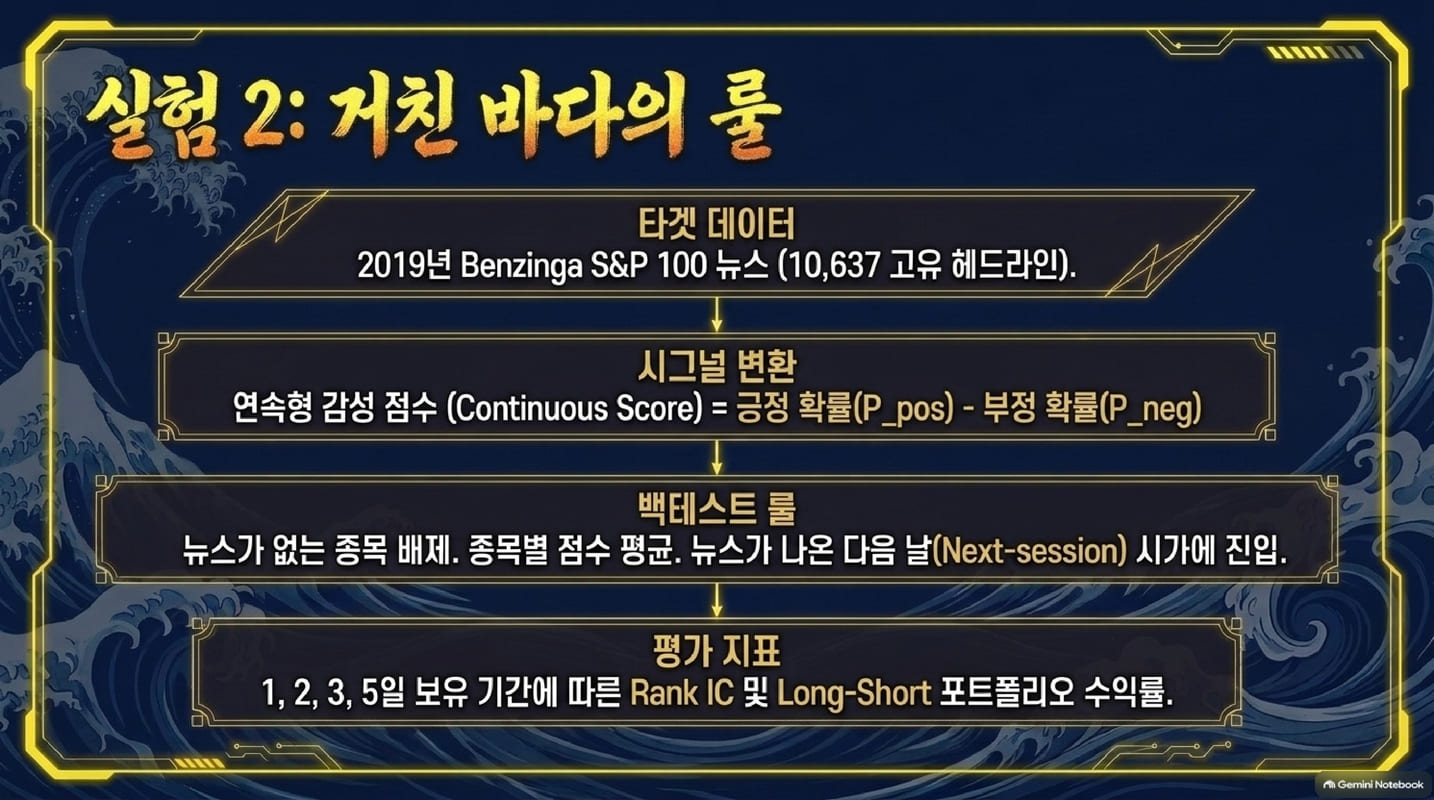
연구진은 모델의 확률값을 연속적인 감성 점수($s = p_{pos} - p_{neg}$)로 변환한 뒤, S&P 100 유니버스 및 2019년 Benzinga 뉴스 데이터(10,637개 헤드라인)를 활용해 주가 예측력(Experiment 2)을 검증했습니다. 뉴스가 발표된 다음 날 시가 진입(Next-session open)을 가정한 보수적인 조건입니다.
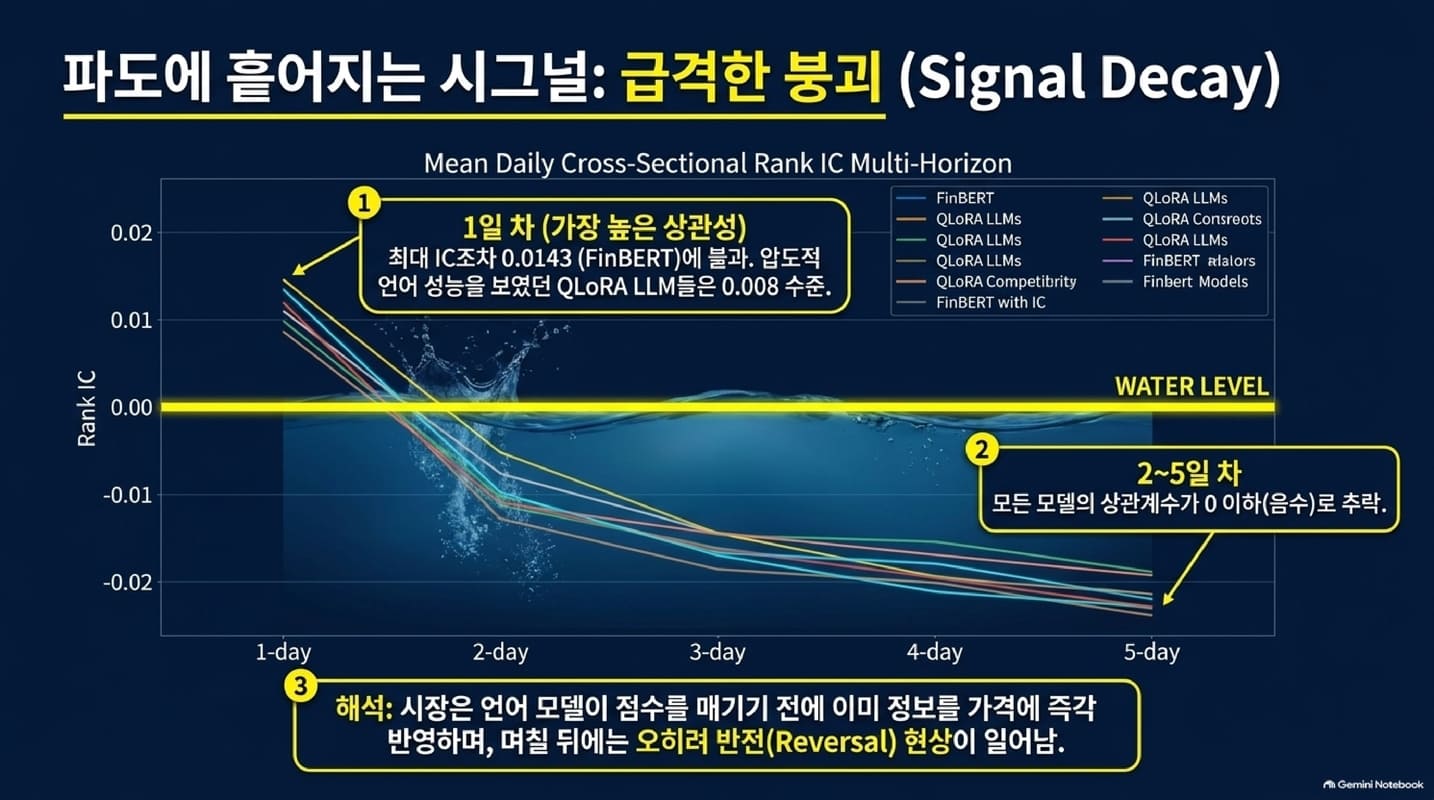
- 구관이 명관, FinBERT의 반전: 1일 차 보유 기간 Rank Information Coefficient(Rank IC)에서 최신 8B LLM들을 제치고 가장 작고 오래된 FinBERT가 0.0143으로 가장 높은 예측력을 기록했습니다.
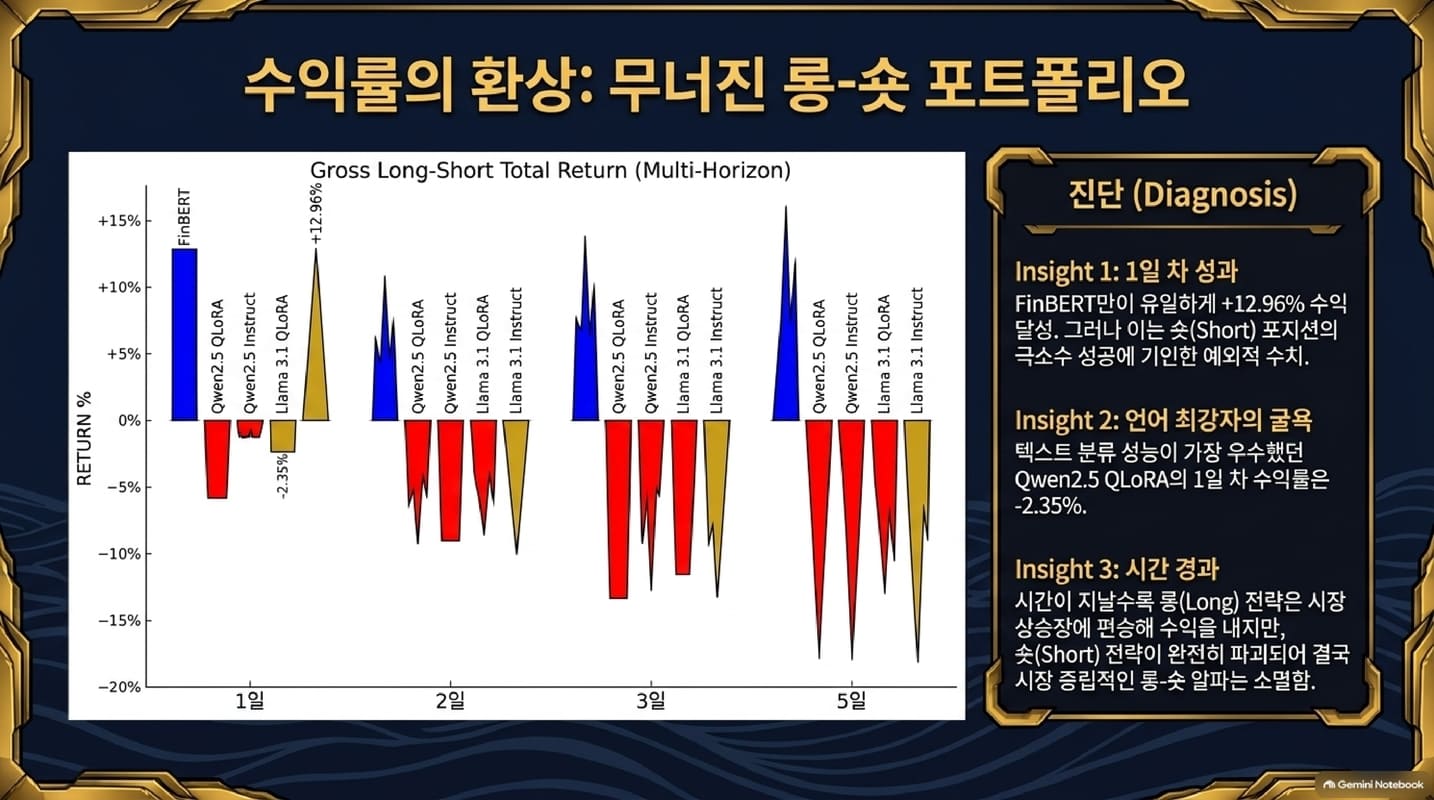
- 포트폴리오 수익률의 착시: FinBERT의 1일 차 롱-숏(Long-Short) 포트폴리오 연환산 수익률은 12.96%로 가장 높았으나, 이는 매수(Long) 성과(4.05%)보다 매도(Short) 포지션의 19.73% 수익률이 이끌었습니다. 즉, 호재를 맞히는 능력보다 특정 악재 종목의 하락 변동성을 포착한 결과에 가깝습니다.
- 통계적 유의성 완전 소멸: Newey-West 추론과 FDR(False Discovery Rate, 허위 발견율) 보정을 적용하자, 28개 모델-보유기간 테스트 중 통계적으로 유의미한 초과 수익 신호는 단 하나도 남지 않았습니다 (최소 q-값 0.9622).
- 신호의 급격한 감쇠: 2일 차 이상 보유 기간에서는 모든 모델의 Rank IC가 음수로 전환되거나 노이즈 수준으로 떨어졌습니다.
왜 언어 모델의 정확도는 주가 예측으로 이어지지 않을까?
언어 이해력이 뛰어난 LLM이 주가 예측에서 고전하는 이유는 세 가지 전략적 요인에 기인합니다.
- 정보 반영 속도(Market Efficiency)의 불일치: S&P 100과 같은 대형주는 정보 효율성이 매우 높습니다. 뉴스가 공개된 후 익일 시가에 진입하는 방식은 이미 시장 참가자들이 몇 분 만에 정보를 가격에 선반영(Priced-in)한 뒤 진입하는 '뒷북'이 됩니다.
- 감정(Sentiment)과 기대치(Surprise)의 구조적 갭: LLM은 텍스트의 언어적 맥락을 정확히 분류하지만, 실제 주가의 비정상 수익률(Abnormal Return)은 단순한 긍정/부정이 아니라 "시장의 사전 기대치 대비 얼마나 서프라이즈인가"에 의해 결정됩니다.
- 노이즈의 과대 해석: 정교한 8B급 LLM은 문장의 미세한 맥락에 지나치게 집중하다가 오히려 시장의 단순하고 실용적인 신호를 놓치거나, 불필요한 노이즈까지 과하게 해석하는 경향이 있습니다.
중급 투자자와 퀀트 트레이더를 위한 실전 시사점
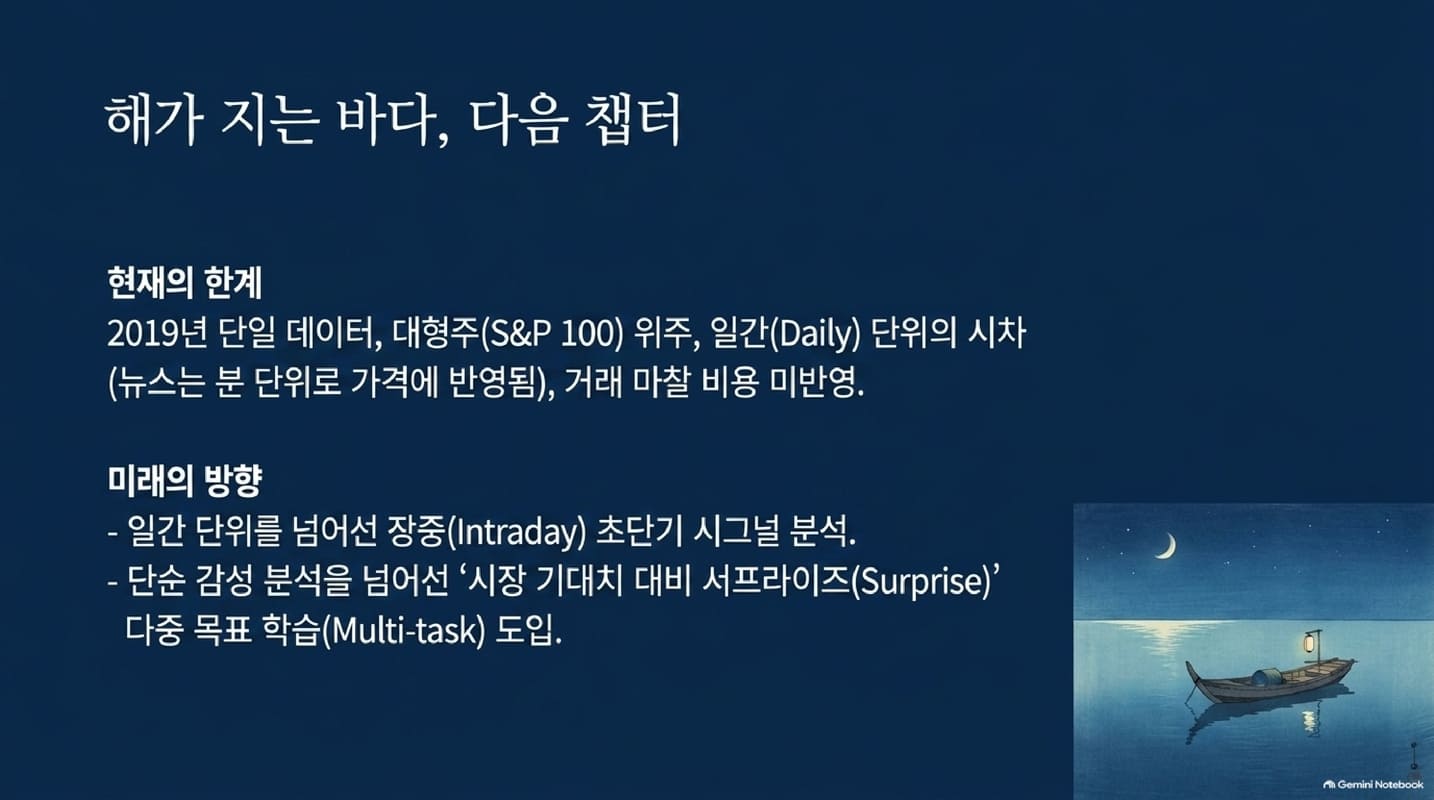
- 타임프레임의 세분화 (Intraday Timing): 일간(Daily) 단위의 감성 신호는 이미 효율적 시장에서 알파가 소멸한 상태입니다. 뉴스 발생 즉시 대응하는 5분, 30분, 1시간 단위의 초단기 비정상 수익률 추정이 필요합니다.
-
$$AR_{i,t}^{(h)} = R_{i,t}^{(h)} - R_{benchmark,t}^{(h)}$$
- 기대치 기반 다중 학습(Multi-task Learning): 텍스트 분류 목적함수만 학습시키기보다는, 주가 변동 폭이나 컨센서스 대비 서프라이즈 여부를 함께 학습하는 다중 목적 함수를 도입해야 합니다.
- 리스크 팩터 중립화(Neutralization): 뉴스 감성 점수가 시장 베타(Market Beta), 산업(Sector), 모멘텀 등 기존 팩터 영향에 휘둘리지 않도록 통계적 중립화를 거쳐야 비로소 순수한 '감성 알파'를 추출할 수 있습니다.
AI의 뛰어난 독해력이 곧바로 투자 계좌의 초과 수익으로 직결되지 않는다는 점은 퀀트 투자에 중요한 경각심을 줍니다. 정교한 언어 모델 구축 자체보다 중요한 것은 데이터의 시의성(Intraday Timeliness), 시장의 기대치(Surprise), 그리고 엄격한 리스크 통제 로직이라는 점을 기억해야 합니다.
함께 읽어볼 글:
퓨어 알파(Pure Alpha)와 퓨어 베타(Pure Beta)의 메커니즘과 성과 분석: 퀀트 투자 전략의 새로운 지평
퓨어 알파(Pure Alpha)와 퓨어 베타(Pure Beta)의 메커니즘과 성과 분석: 퀀트 투자 전략 핵심 정리 성공적인 퀀트 투자를 위해서는 시장의 소음(Noise)에서 수익의 본질인 정보를 분리하는 설계가 핵심
wejump3.tistory.com
